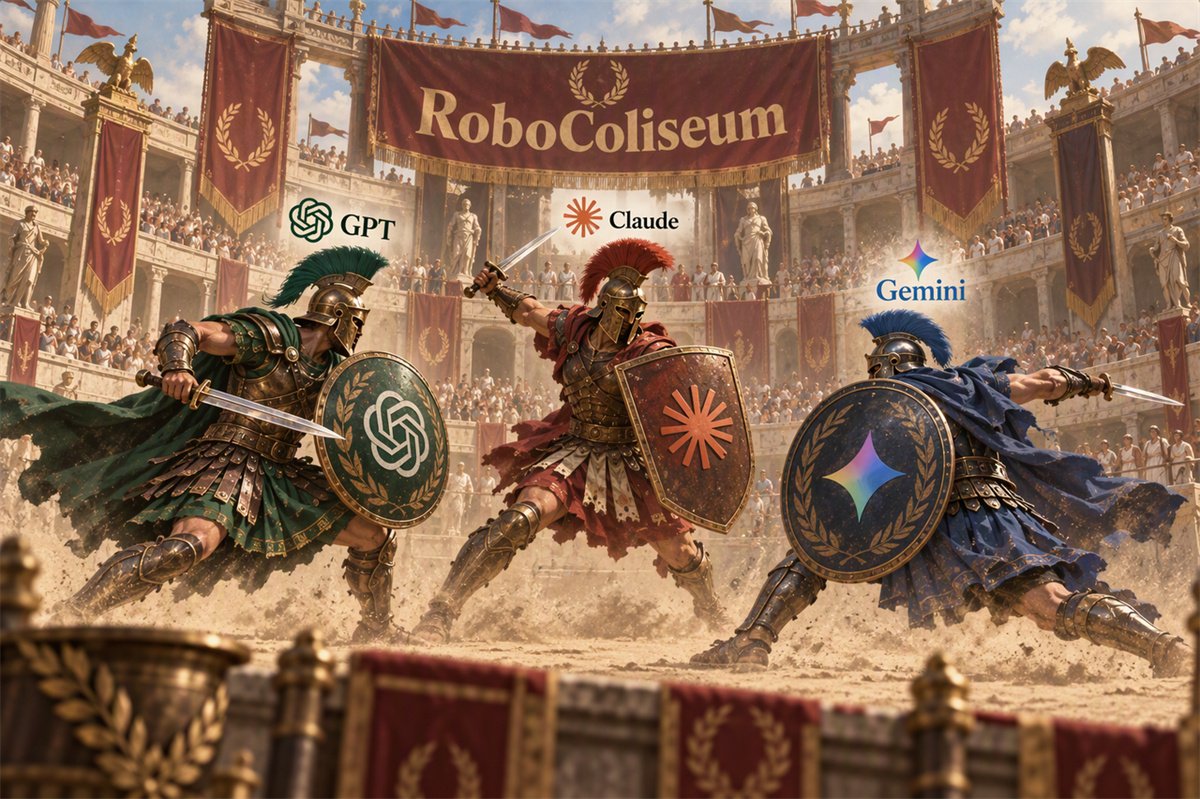
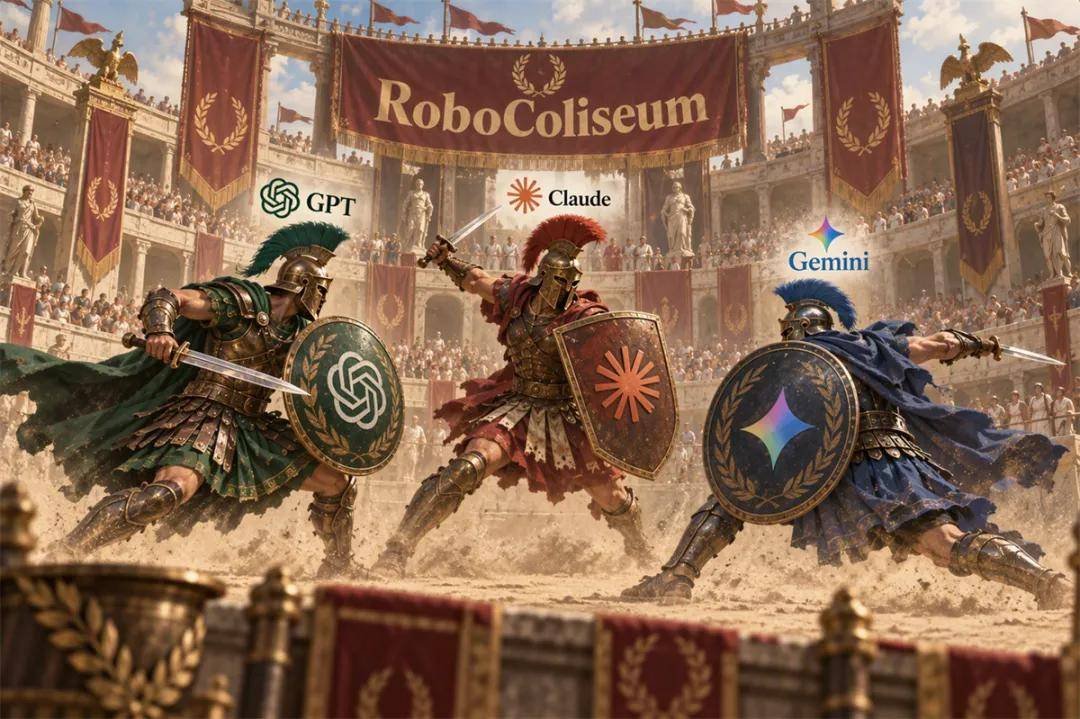
Quando i modelli di punta dei tre giganti dell'IA OpenAI, Anthropic e Google si sfidano sullo stesso palco, chi è più abile nel controllare i robot?
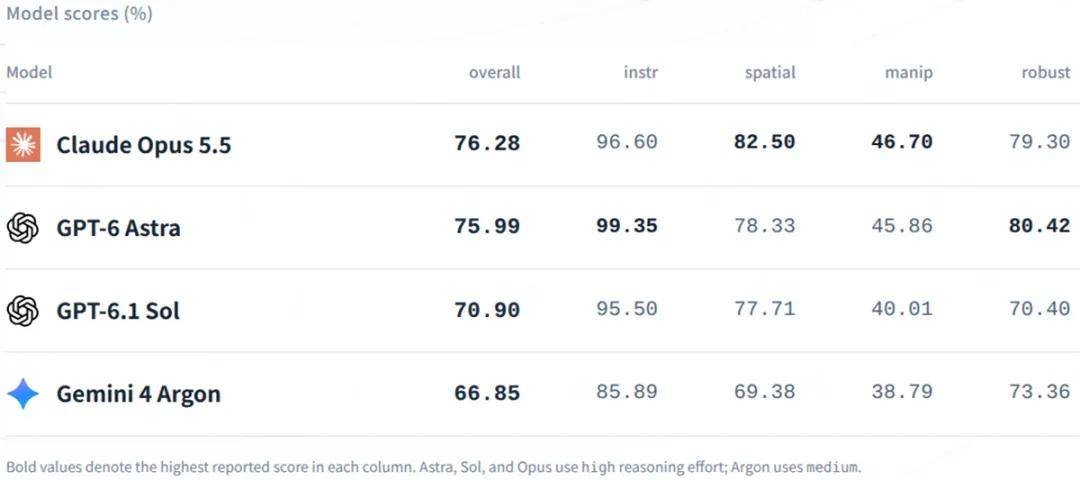
Il 20 ottobre, RoboColiseum, l'arena embodied co-fondata da quasi 20 università, aziende e istituti di ricerca a livello globale tra cui Mifeng Technology, Hugging Face, NVIDIA e l'Università Tsinghua, ha pubblicato i risultati di questo ciclo di valutazione: Claude Opus 5.5 si classifica primo nella classifica complessiva tra i quattro modelli di punta, seguito da GPT-6 Astra.
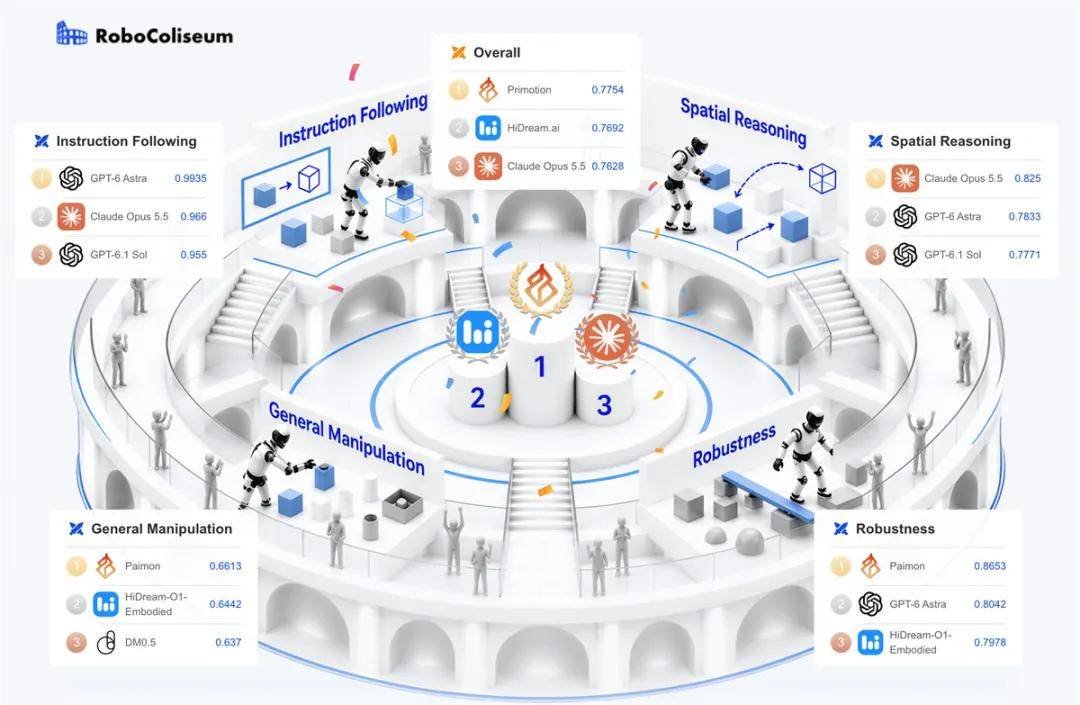
Analizzando le singole categorie, tra i quattro modelli di punta GPT-6 Astra guida nel follow delle istruzioni e nell'adattamento complessivo alle perturbazioni, con un punteggio di 99,35 nel follow delle istruzioni; Opus performa meglio nella comprensione spaziale e nelle operazioni generali, conquistando il primo posto complessivo nel gruppo flagship con il minor consumo di token su tutti i round di valutazione. Nei test con perturbazioni della qualità delle immagini, GPT-6.1 Sol è nettamente indietro rispetto agli altri tre modelli, evidenziando differenze di stabilità tra i vari modelli di fronte a variazioni delle informazioni visive.
Tuttavia, i primi due posti della classifica complessiva di questo ciclo sono ancora occupati da modelli di policy embodied, che mantengono il vantaggio soprattutto nella dimensione delle operazioni generali.
Questo confronto sullo stesso palco offre al settore un riferimento intuitivo per comprendere i punti di forza e le lacune dei modelli generali di grandi dimensioni e dei modelli di policy embodied.
RoboColiseum, incentrato su follow delle istruzioni, comprensione spaziale, adattamento alle perturbazioni e operazioni generali, ha lanciato quattro sotto-classifiche di capacità e 78 task di valutazione in simulazione ad alta fedeltà, che presentano sia le prestazioni per categoria dei modelli sia registrano i passaggi di completamento dei task e le posizioni di fallimento, aiutando gli sviluppatori a individuare rapidamente le lacune di capacità dei modelli.
In qualità di co-fondatore, Mifeng fornisce a RoboColiseum asset di oggetti ad alta fedeltà e scenari di simulazione, supportando la costruzione di ambienti di valutazione per complessi task di manipolazione robotica e fornendo risorse di base per test delle capacità dei modelli in condizioni di interazione con diversi oggetti, layout spaziali e condizioni ambientali.
Se i risultati dei modelli in simulazione possano riflettere le prestazioni operative reali è anch'esso un aspetto chiave della valutazione. Secondo i risultati dei test reali pubblicati dalla piattaforma, la correlazione tra la valutazione in simulazione di RoboColiseum e il deployment su robot reali raggiunge l'89,5%, e la differenza di valutazione dello stesso modello tra simulazione e mondo reale è inferiore al 10%, offrendo agli sviluppatori un riferimento per la selezione dei modelli e l'individuazione dei problemi prima di passare ai test su robot reali.
Mifeng Technology offre un sistema di fornitura dati "completo, valido e rapido", che copre tre paradigmi di dati: robot reale, simulazione e senza corpo. Nel campo della simulazione, Mifeng fornisce due categorie di risorse, asset di oggetti e asset ambientali, che coprono una varietà di oggetti quotidiani e scenari indoor, e offre capacità quali ricostruzione di scene, acquisizione di dati di traiettorie esperte e visualizzazione dei risultati di valutazione, aiutando i team di modelli a condurre training e valutazioni diversificati.
Coliseum si riferiva originariamente all'anfiteatro romano; RoboColiseum ne riprende l'immagine per costruire un sistema di valutazione sistematico e multidimensionale, creando per i modelli di intelligenza embodied un'"arena" e un'"area di addestramento" pubbliche, neutrali e riproducibili, con valutazioni in simulazione altamente coerenti con le prestazioni su robot reali. Qualsiasi università, istituto di ricerca o sviluppatore aziendale può inviare il proprio modello per sostenere una serie standardizzata di "esami". Dal lancio ad agosto, oltre 100 team in Cina e all'estero hanno condotto training e valutazioni dei modelli sulla piattaforma.
RoboColiseum è ora aperto agli sviluppatori di tutto il mondo; i team di modelli sono invitati a partecipare alla valutazione.